Uma trilha de engenharia de dados que começa no web scraping e termina com o pipeline em produção.
Aulas práticas, em ordem: você extrai dados de sites reais, transforma, carrega em banco e nuvem, orquestra, analisa e aplica IA. A plataforma confere cada entrega. Em português e inglês.
crawler.pyextrair.py
Python 3.12editável: mude PAGINAS ou INTERVALO e rode
🔒marketplace.example/s?k=console+gx5
Enviar para Bela Vista 01319console gx5Olá, faça seu login
Contas e Listas0
Contas e Listas0
☰ TodosOfertas do DiaGamesEletrônicosLivros
Resultados
Patrocinado
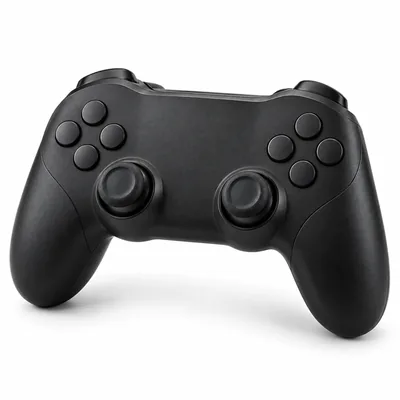
Controle - GX5
★★★★★ (13.5 mil)R$402,80
Patrocinado
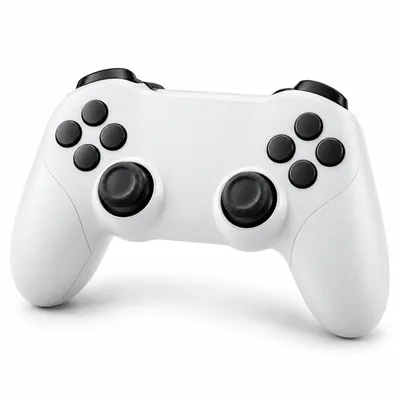
Controle sem fio – Branco
★★★★★ (13.5 mil)R$417,05
Patrocinado
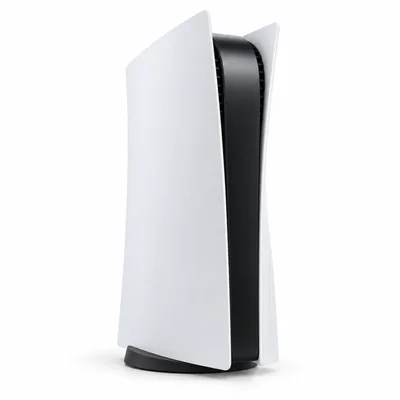
GX5 Edição Digital 825GB 1 Controle
★★★★★ (13.5 mil)R$4.025,53
Patrocinado
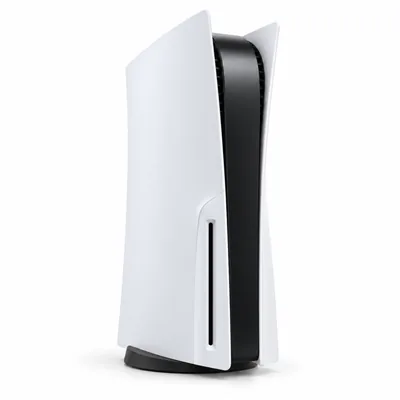
GX5 Slim Disk 1TB 1 Controle Branco
★★★★★ (13.5 mil)R$4.999,90
Patrocinado
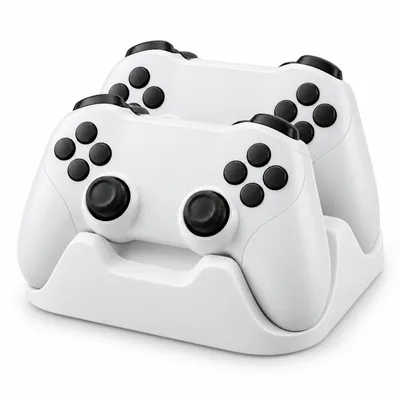
Base De Carregamento Do - GX5
★★★★★ (13.5 mil)R$169,00
Patrocinado
Console GX5 - Digital Edition
★★★★★ (13.5 mil)R$4.226,55
Edita o script se quiser. Depois roda.
precos0registros
| titulotext | preconumeric | paginaint2 | |
|---|---|---|---|
| — | |||
A trilha, na ordem em que o dado anda
1ETLDo primeiro request ao dado guardado.221 aulas
2Engenharia de dadosO que faz isso rodar sozinho, em escala, na nuvem.171 aulas
3Dados em usoAnálise, modelos, IA e o projeto de portfólio.126 aulas
clique numa área para ver os capítulos
Você faz, a plataforma confere
Sete etapas com testes. Cada uma libera a próxima.
- 1fetch
- 2parse
- 3fronteira
- 4dedup
- 5limite por host
- 6retomada
- 7relatório
$ glearn test
Gabriel GrecoEngenheiro de dados em São Paulo
Passei os últimos anos coletando dados em escala: operando crawlers na Zyte, construindo a aquisição global e os índices do Red Tape Index na Labrynth e automatizando o que dava na Lumma. O curso é o caminho que eu queria ter tido.
Ver experiência completa ↗ Zyte30 birequests por ano operados
 Labrynth · Red Tape Index2 birequests coletando dados públicos em 4 continentes
 Lumma4.500 hpor mês automatizadas
Entre na lista da turma 1
- Acesso antes de abrir para todo mundo.
- A primeira aula sem conta, assim que ficar pronta.
Perguntas frequentes
- Preciso saber programar?
- O básico de Python: variáveis, for, funções, abrir um arquivo. A primeira aula não pede nada disso e os capítulos iniciais revisam o que precisa.
- O que eu preciso instalar?
- Python 3.12, um terminal e um editor. Docker, Postgres e a nuvem entram nas partes 2 e 3, e cada capítulo traz o passo a passo de instalação.
- Em que ordem eu faço?
- Na ordem da trilha: Extrair, Transformar, Carregar, depois engenharia e depois análise, ciência de dados e IA. Cada capítulo usa o dado que você coletou no anterior.
- Quanto tempo leva?
- Cerca de 190 horas de aula e prática, no seu ritmo. Com 5 horas por semana, dá uns 9 meses; com 10, uns 4 ou 5.
- Como a plataforma confere?
- Cada aula termina numa entrega: um dataset, um comando rodado no terminal, uma tabela no banco, um pipeline agendado. A plataforma checa o resultado, não um quiz.
- O que eu construo?
- 17 projetos, do primeiro crawler ao pipeline em nuvem com orquestração, qualidade, dashboard e IA em cima. Todos ficam no seu GitHub como portfólio.
- Já sei scraping. Vale a pena?
- Dá para pular capítulos passando no desafio equivalente. As partes 2 e 3 (bancos, orquestração, escala, nuvem, análise, IA) são o que a maioria dos cursos de scraping não tem.
- Cobre anti-bot e bloqueios?
- Sim, com engenharia reversa de proteções, fingerprint, proxies e o raciocínio estatístico de quando insistir e quando parar. Sempre sobre dados públicos e respeitando limites dos sites.
- Posso usar IA nas aulas?
- Sim. Há um caminho com IA e um sem. A parte 3 ensina a usar LLMs para extrair, classificar e responder perguntas sobre o que você coletou, com agentes e MCP.
- É em português?
- Português e inglês, com as mesmas aulas, os mesmos labs e a mesma verificação. Os vídeos têm até 10 minutos.
- Quando abre?
- Em capítulos, na ordem da trilha. A primeira aula abre para quem está na lista, sem precisar de conta.
- Funciona no celular?
- As aulas guiadas e os simuladores, sim. Terminal, Docker e nuvem pedem computador.